怎么发起
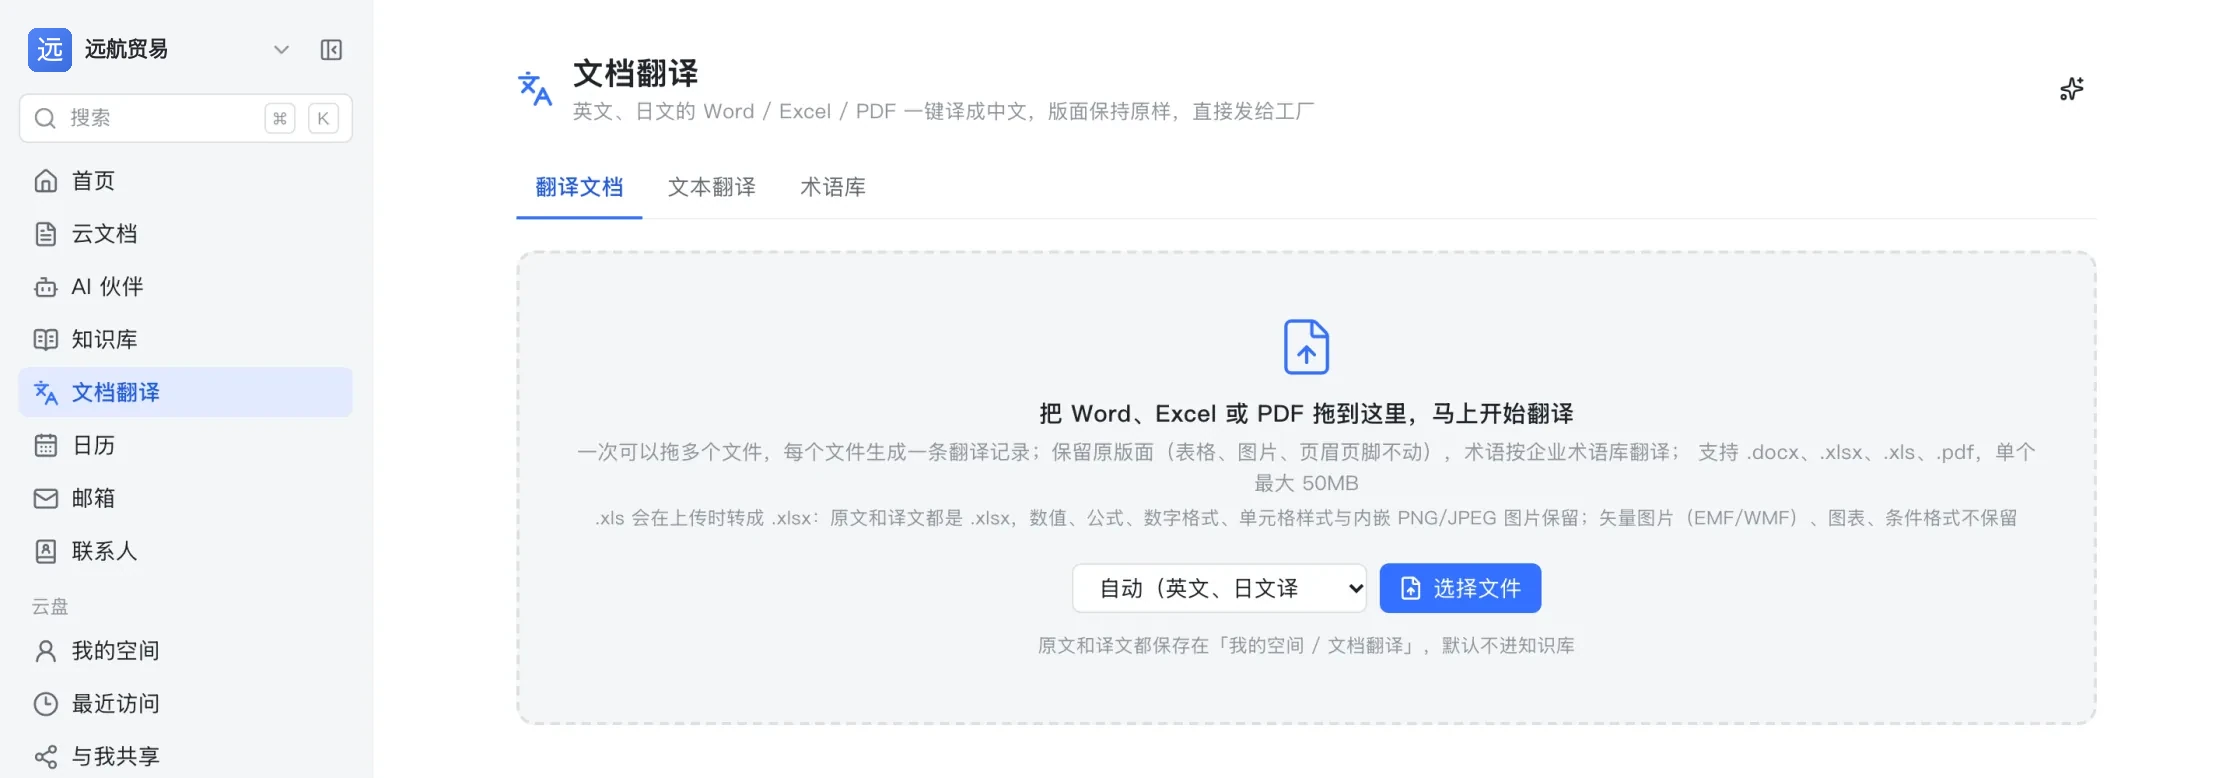
- 在「文档翻译」页把 Word / Excel / PDF 拖进来,或在云盘里对文件点「翻译」。
- 选择目标语言,确认开始。
- 完成后进入对照预览;需要改的地方在「逐段校对」里改,改完「更新译文文件」。
- 原文与译文放在「我的空间 / 文档翻译」下,并且和普通文件一样默认入库,译完就能被检索到。
演示环境 · 文档翻译
版面是怎么保留的
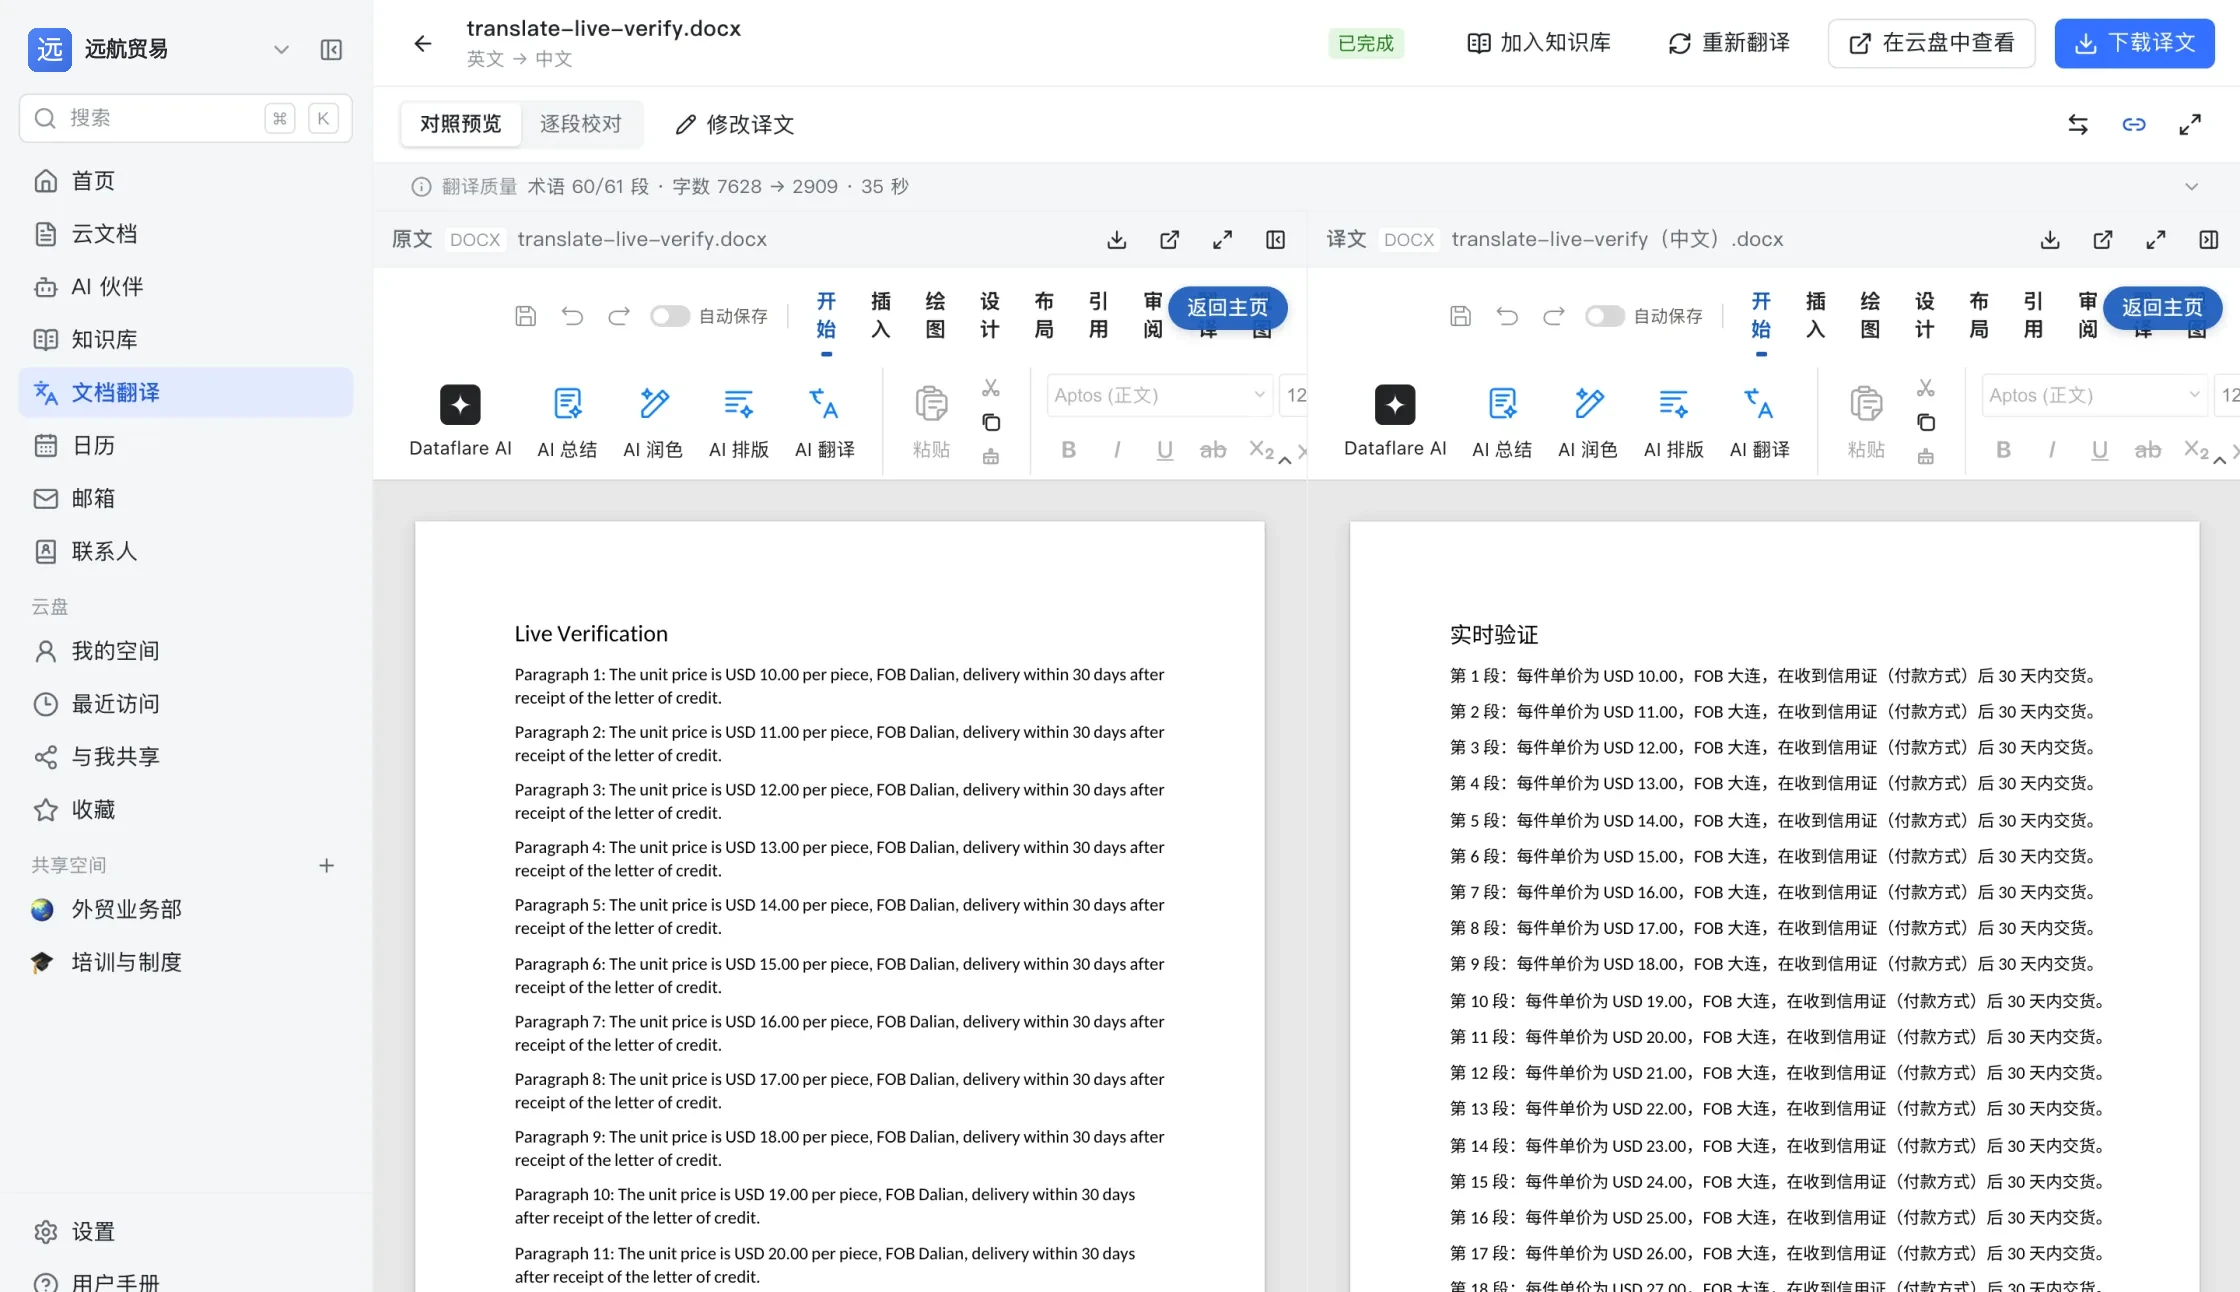
- docx:只替换文字节点,页眉页脚、表格、编号与域结果全部保持原样。
- xlsx:只改共享字符串与内联文本单元,公式、数字、合并单元格一律不动;同一个共享串被多格引用时,译文一起变。
- 老 .xls:先转成 xlsx 再走同一条链路,数值、公式与缓存值、数字格式、列宽、合并单元格与单元格样式都保留。
- PDF:在原页原位置盖色重写,不是「转成 Markdown 再导出」。
演示环境 · 对照预览
老 .xls 会丢图表、图片与条件格式;.doc 老格式不支持翻译,请先另存为 .docx。
校对与译文更新
- 对照预览左右两栏滚动同步:滚原文,译文跟着走,一行一行还对得上。
- 逐段校对里能改每一段译文;没按企业术语库译法出现的术语会被标出来,提醒你核对。一次最多渲染 200 段,改完保存成译文的新版本。
- 译文只在整份翻完之后生成一次正式文件;中途的进度只影响过程,不会覆盖已经在用的译文版本。
运行中与取消
翻译过程中页面是双栏舞台:左边是原文的真预览,右边是跟着进度不断刷新的译文预览,可以随时停止。停止后还没开始的分段不再领取,正在跑的分段在批间收手;那份预览件是临时的,不会进版本历史,任务结束就删掉。
扫描件
没有文字层的 PDF 页和图片走平台后台配置的视觉模型做版面识别;没配置时明确标成「需要 OCR」,不会当成空文档糊弄过去。